내 문서·자료를 AI가 안전하게 참고하게 만드는 흐름(수집·정제·청킹·임베딩·검색·근거표기)을, 개인정보 비식별과 출처 대조를 게이트로 삼아 행정 실무에 얹는 실전 모듈.
4컷으로 보기 — RAG는 '근거 서류철 정리
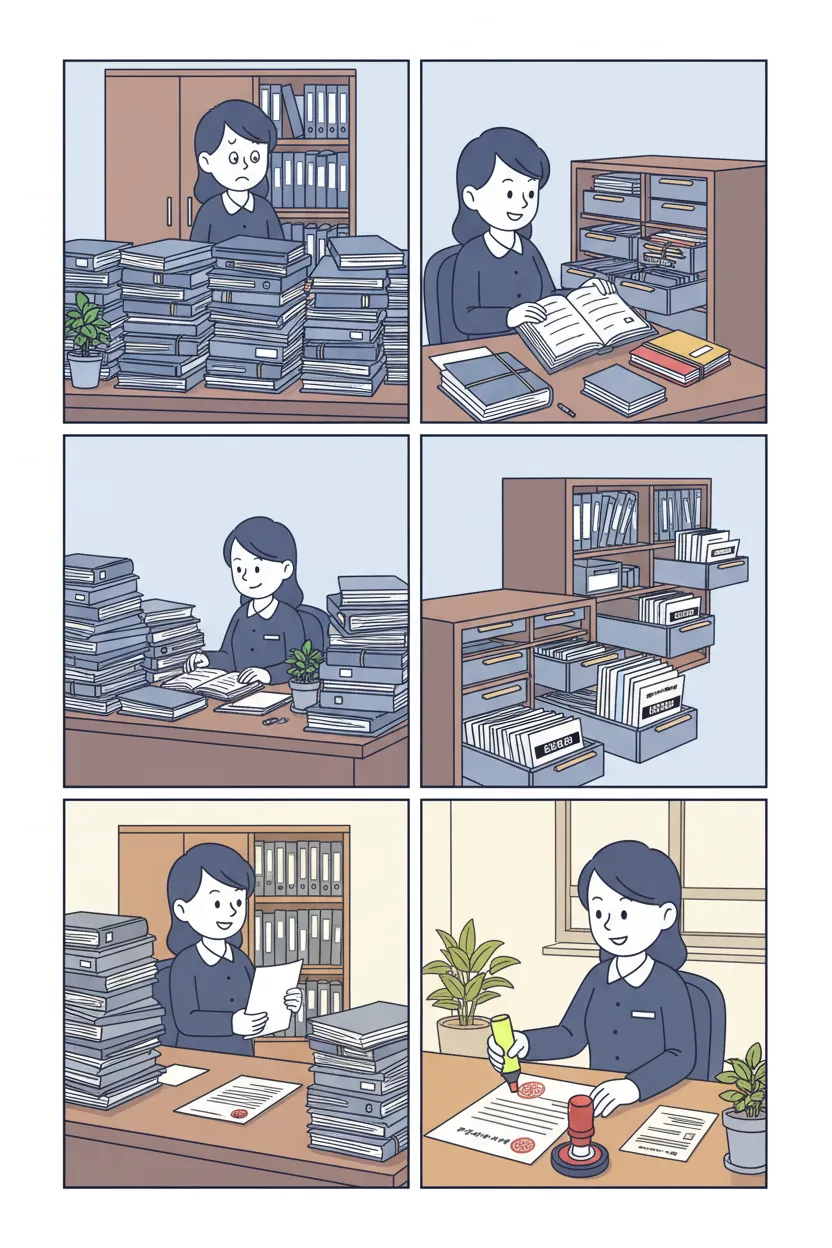
- 1산더미 서류에 파묻힌 담당자
- 2간지 끼워 서랍 색인 정리 시작
- 3비슷한 서류철 척척 꺼내오기
- 4형광펜 근거 붙여 결재 완료
왜 중요한가
공무원이 AI를 실제로 쓰는 순간의 90%는 "내가 가진 자료(공문·법령·업무편람·회의록·통계표)를 근거로 답하게 하고 싶다"는 요구다. 이걸 프롬프트에 통째로 붙여넣으면 (1)창(context window)을 넘겨 잘리고 (2)개인정보가 외부 LLM으로 유출되며 (3)출처를 되짚을 수 없어 환각을 감사에서 방어할 수 없다. RAG(검색증강생성)는 이 세 실패를 동시에 막는 표준 해법이다. 이 모듈이 없으면 학습자는 '그럴듯하지만 근거 없는 답'을 공문에 붙이고, 비식별 없이 민감정보를 제3자 API로 흘리며, 최신성이 지난 폐지 법령을 인용하게 된다. 즉 부재 시 실패는 '감사 지적·개인정보보호법 위반·행정 신뢰 훼손'으로 직결된다.
행정 실무 비유
RAG는 '근거 서류철 정리·법령 대조·출처 되짚기'의 자동화다. 담당자가 기안할 때 (1)관련 문서를 캐비닛에서 찾아(retrieval) (2)해당 조항·페이지에 형광펜을 긋고(citation) (3)그 근거만 요약해 결재 문서에 붙이는(grounded generation) 절차와 똑같다. 청킹은 두꺼운 편람을 '조·항·별표' 단위로 간지를 끼워 나누는 일, 임베딩은 '내용이 비슷한 서류끼리 같은 서랍에 꽂는' 색인 체계, 벡터검색은 '이 민원과 비슷한 과거 사례철을 서랍에서 뽑아오는' 검색이다. 비식별 선처리는 서류를 캐비닛에 넣기 전 주민번호에 검은 테이프를 붙이는 마스킹, 최신성 관리는 폐지·개정된 서류를 서류철에서 즉시 빼는 문서 정리 규정이다.
🖐 실무 따라하기 — 복붙해서 따라 하면 됩니다
- 1근거 서류철 만들기: 합성 편람 파일 준비
작업 폴더를 하나 만들고, 그 안에 실습용 합성 민원편람을 '편람.txt'로 저장한다. 파일 맨 위 대괄호에 버전/발효일을 적어 두는 것이 핵심(나중에 최신성·출처 표기에 쓰임). 아래 블록을 터미널(맥: 터미널, 윈도우: PowerShell)에 그대로 붙여넣기. 맨 끝 ls는 파일이 실제로 만들어졌는지 눈으로 확인하려고 넣은 것.
터미널 명령mkdir rag-민원 && cd rag-민원 cat > 편람.txt <<'EOF' [민원편람 v2026.3 / 발효일 2026-07-01] ## 전입신고 전입신고는 새로운 거주지에 전입한 날부터 14일 이내에 신고해야 합니다. 신고는 세대주 또는 세대원이 할 수 있으며, 온라인(정부24) 또는 읍면동 주민센터 방문으로 가능합니다. 방문 시 신분증을 지참해야 합니다. 정당한 사유 없이 기간 내 신고하지 않으면 5만원 이하의 과태료가 부과됩니다. ## 등본 발급 수수료 주민등록등본을 주민센터 방문하여 발급받는 경우 수수료는 1통당 400원입니다. 정부24를 통한 온라인 발급은 무료입니다. ## 인감증명서 발급 인감증명서는 본인이 신분증을 지참하고 주민센터를 방문하여 발급받습니다. 대리인이 발급받는 경우 위임장과 본인 및 대리인의 신분증이 필요합니다. 발급 수수료는 1통당 600원입니다. EOF ls
→ 결과 cat > ... EOF까지는 화면에 아무것도 출력하지 않는다(파일만 조용히 만들어짐). 맨 끝 ls가 실행되면 화면에 '편람.txt'가 출력된다 — 이게 뜨면 저장 성공이고, 이 파일이 AI가 참고할 유일한 '근거 서류철'이다. (내용을 직접 확인하려면 cat 편람.txt 실행. 윈도우 PowerShell에서 cat<<EOF가 안 되면 메모장으로 EOF 사이 내용을 붙여넣어 UTF-8로 '편람.txt' 저장하고, 저장 위치가 rag-민원 폴더인지 확인)
- 2청킹·색인·검색: 질문에 맞는 조항만 뽑아오기
편람을 '## 소제목' 단위 조각(청크)으로 자르고, 각 청크를 단어 빈도로 색인한 뒤, 질문과 가장 비슷한 청크를 순위로 뽑는 미니 검색기를 만든다. 아래 전문을 'search.py'로 저장하고 실행. (임베딩 모델 설치 없이, 표준 라이브러리만으로 어휘 기반 검색을 구현 — 개념 체감용. 아래는 절단 없는 전문이며 그대로 붙여넣으면 실행된다.)
코드cat > search.py <<'EOF' import re, math from collections import Counter raw = open('편람.txt', encoding='utf-8').read() version = re.search(r'\[(.*?)\]', raw).group(1) # 버전/발효일 sections = re.split(r' (?=## )', raw) # 청킹: 소제목 단위 chunks = [] for s in sections: s = s.strip() if s.startswith('## '): title = s.splitlines()[0][3:].strip() chunks.append({'id': f'chunk-{len(chunks)+1}', 'title': title, 'text': s, 'source': version}) def toks(t): # 한글 2글자쌍 + 숫자/영문 t = t.lower() words = re.findall(r'[0-9]+|[a-z]+', t) grams = [] for h in re.findall(r'[가-힣]+', t): grams += [h] if len(h)==1 else [h[i:i+2] for i in range(len(h)-1)] return words + grams docs = [Counter(toks(c['text'])) for c in chunks] # 색인(단어빈도) def search(q, k=2): # 검색(코사인 유사도) qv = Counter(toks(q)) def cos(a, b): common = set(a) & set(b) num = sum(a[t]*b[t] for t in common) da = math.sqrt(sum(v*v for v in a.values())) db = math.sqrt(sum(v*v for v in b.values())) return num/(da*db) if da and db else 0 ranked = sorted(((cos(qv, d), i) for i, d in enumerate(docs)), reverse=True) return [(round(s,3), chunks[i]) for s, i in ranked[:k]] if __name__ == '__main__': q = '전입신고 기한 지나면 과태료 얼마' print('질문:', q) for s, c in search(q): print(f' score={s} [{c["id"]}] {c["title"]} 출처={c["source"]}') EOF python3 search.py→ 결과 score가 높은 순으로 청크 2개가 뜨고, 맨 위 줄이 정확히 'score=0.336 [chunk-1] 전입신고 출처=민원편람 v2026.3 / 발효일 2026-07-01'로 나온다(로컬 실행으로 검증한 실제 출력값). 즉 질문과 무관한 등본·인감 청크가 아니라 '전입신고' 조항이 1등으로 검색되고, 두 번째 줄은 score=0.0인 다른 청크다. 출처에 발효일이 함께 나와 근거를 되짚을 수 있다.
- 3비식별 선처리: 문의자 개인정보 먼저 지우기
AI에 문의 내용을 넣기 전, 문의자 개인정보(이름·휴대폰·주민번호)를 마스킹한다. 업무 식별자인 접수번호(MW-2026-0001)는 보존한다. 'mask.py'로 저장하고 실행. (전부 합성 데이터. 아래는 절단 없는 전문.)
코드cat > mask.py <<'EOF' import re sample = '문의자 홍길동(010-0000-0000), 주민번호 900101-1234567 님, 접수번호 MW-2026-0001' m = sample m = re.sub(r'\d{6}-\d{7}', '******-*******', m) # 주민등록번호 m = re.sub(r'01[016789]-?\d{3,4}-?\d{4}', '010-****-****', m) # 휴대폰(합성 010-0000-0000도 마스킹됨) m = re.sub(r'[가-힣]{2,4}(?=\s*\()', '###', m) # 괄호 앞 이름 print('원본:', sample) print('처리:', m) EOF python3 mask.py→ 결과 두 줄이 출력되고, '처리:' 줄이 정확히 '문의자 ###(010-****-****), 주민번호 ******-******* 님, 접수번호 MW-2026-0001'로 나온다(로컬 검증). 즉 홍길동→###, 합성 전화 010-0000-0000→010-****-****, 900101-1234567→******-*******로 바뀌고, 접수번호 MW-2026-0001은 그대로 남는다. 주의: 접수번호도 다른 정보와 결합하면 개인 특정이 가능하므로, 실무에서 외부 AI로 보낼 때는 접수번호까지 [접수번호]로 가리는 것을 권장한다. 이 마스킹된 텍스트만 다음 단계에서 AI에 전달한다(원본 개인정보는 AI로 보내지 않음).
- 4그라운딩+인용: 검색된 근거로만 답변 초안 생성
step2에서 뽑힌 청크 본문을 '근거'로 넣고, '근거에 없으면 지어내지 말 것 + 문장 끝에 출처 표기'를 강제하는 프롬프트로 답변 초안을 만든다. 아래 프롬프트 전문을 ChatGPT/Claude 웹 또는 이 플랫폼 /playground 입력창에 그대로 붙여넣기. (근거 블록은 step2 실행 결과의 chunk-1 본문을 그대로 넣었다. 무설치 대안이 바로 이 단계다.)
프롬프트 (복사해서 AI에 입력)당신은 경북도청 민원 답변 보조자입니다. 반드시 아래 [근거]에 있는 내용만 사용해 답하세요. 규칙: 1) [근거]에 없는 수치·기한·금액·법조문은 절대 지어내지 마세요. 없으면 "편람에서 확인되지 않습니다"라고 답하세요. 2) 답변의 각 문장 끝에 근거의 (출처/청크ID)를 괄호로 표기하세요. 3) 답변 맨 끝에 '근거 버전:' 줄로 편람 버전과 발효일을 적으세요. [질문] 전입신고 기한을 넘기면 과태료가 얼마인가요? (접수번호 MW-2026-0001) [근거] (출처: 민원편람 v2026.3 / 발효일 2026-07-01, chunk-1 전입신고) 전입신고는 새로운 거주지에 전입한 날부터 14일 이내에 신고해야 합니다. 정당한 사유 없이 기간 내 신고하지 않으면 5만원 이하의 과태료가 부과됩니다.
→ 결과 답변에 '전입한 날부터 14일 이내 신고', '정당한 사유 없이 넘기면 5만원 이하 과태료'가 나오고 문장 끝마다 (chunk-1 전입신고) 같은 출처가 붙는다. 맨 끝에 '근거 버전: 민원편람 v2026.3 / 발효일 2026-07-01'. 그라운딩이 되는지 반증 테스트: [질문]을 '전입신고 과태료 분할납부 되나요?'로 바꿔 다시 넣으면 근거에 없는 내용이라 '편람에서 확인되지 않습니다'가 나와야 성공(지어내면 실패).
- 5정답셋 평가: 검색이 맞는 조항을 뽑는지 점검
질문마다 '정답 청크'를 미리 적어둔 정답셋을 만들고, step2의 검색기가 1등으로 정답 청크를 뽑는지(Top-1 적중률) 자동 채점한다. 'eval.py'로 저장하고 실행. (from search import search로 step2 검색기를 그대로 재사용하므로 search.py와 같은 폴더에서 실행할 것. 아래는 절단 없는 전문.)
코드cat > eval.py <<'EOF' from search import search gold = [ ('전입신고 기한 지나면 과태료 얼마', 'chunk-1'), ('주민등록등본 방문 발급 수수료', 'chunk-2'), ('인감증명서 대리 발급 필요서류', 'chunk-3'), ] hit = 0 for q, ans in gold: top = search(q, k=1)[0][1]['id'] ok = (top == ans) hit += ok print(f'{"O" if ok else "X"} 질문:{q} → top:{top} / 정답:{ans}') print(f'Top-1 적중률: {hit}/{len(gold)} = {hit/len(gold)*100:.0f}%') EOF python3 eval.py→ 결과 세 질문 모두 'O'가 뜨고 마지막 줄에 정확히 'Top-1 적중률: 3/3 = 100%'가 출력된다(로컬 검증 완료). 만약 X가 나오면 편람.txt가 같은 폴더에 있는지, search.py가 정상 저장됐는지 먼저 확인하고, 그래도 X면 청킹 단위를 더 잘게 쪼개거나 질문 표현을 바꿔 재측정 — 이렇게 '정답셋으로 검색 품질을 수치로 관리'하는 것이 RAG 운영의 핵심 게이트.
스택 내 위치
5계층 스택(①프롬프트 ②컨텍스트 ③하네스 ④헤르메스 ⑤메타) 위에 얹히는 '실전' 모듈. 컨텍스트 계층(context-eng)이 "무엇을 언제 창에 넣느냐"의 원리라면, data-rag는 그 컨텍스트를 '내 서류철'에서 뽑아 오는 실제 배관(pipeline)이다. 횡단으로 eval-eng(검색 품질 측정), 기반으로 env-setup(합성 데이터셋·망분리)과 맞물리고, ai-security(비식별 선처리)를 인제스션 앞단에 강제한다.
핵심 개념 (13)
모델이 답하기 전에 외부 문서 저장소에서 관련 조각을 '검색'해 프롬프트에 넣고, 그 근거 위에서만 '생성'하게 하는 구조. 파인튜닝(모델 자체를 바꾸는 것)과 달리 지식을 외부 문서에 두므로, 문서만 갈아끼우면 최신성과 출처 추적이 유지된다.
💡 내 자료를 근거로 답하게 하면서 환각을 억제하고 출처를 되짚는 표준 해법. 행정에서 '근거 없는 자동응답'은 감사 리스크의 직접 원천이라 필수.
긴 문서를 검색·임베딩 단위로 잘게 나누는 작업. 너무 크면 무관한 내용이 섞여 검색 정확도가 떨어지고, 너무 작으면 문맥이 끊긴다. 문단·조항 경계 존중, 적정 크기, 조각 간 겹침(overlap) 유지가 핵심.
💡 검색 품질의 8할이 청킹에서 결정된다. 법령은 조·항, 편람은 절 단위로 자르는 등 '행정 서식의 구조'를 살려야 인용이 조항 단위로 깔끔해진다.
텍스트 조각을 '의미가 가까우면 좌표도 가까운' 숫자 벡터로 바꾸는 변환. 키워드가 정확히 일치하지 않아도 '뜻이 비슷한' 문서를 찾을 수 있게 해준다.
💡 '출산장려금'으로 검색해도 '아이 낳으면 주는 지원금' 문서를 찾아주는 의미 검색의 토대. 다만 임베딩 생성도 텍스트를 외부로 보내는 행위라 비식별이 선행돼야 한다.
임베딩 벡터를 저장하고, 질의 벡터와 가장 가까운 조각을 빠르게 찾아주는 검색용 데이터베이스. 근사최근접(ANN) 색인으로 대량 문서에서도 수 밀리초에 후보를 뽑는다.
💡 '비슷한 서류가 꼽힌 서랍'에 해당. 어떤 벡터스토어를 쓰느냐(로컬 파일 vs 관리형 서비스)가 망분리·데이터 반출 판단과 직결된다.
질의와 관련된 문서 조각 상위 K개를 저장소에서 뽑아오는 단계. 뽑힌 조각이 답의 근거가 되므로, 여기서 놓치면(재현율 낮으면) 아무리 좋은 모델도 근거 없이 답한다.
💡 RAG 품질의 병목. '검색이 틀리면 생성도 틀린다(garbage in, garbage out)'. eval-eng의 정답셋 평가가 바로 이 단계를 겨냥한다.
모델이 '검색된 근거 안에서만' 답하고, 근거에 없으면 '모른다/자료 없음'이라 말하게 강제하는 것. 프롬프트 지시와 후단 검증으로 환각을 억제한다.
💡 환각을 공문에 붙이는 사고를 막는 안전선. 안전 게이트 G3(출처·환각)의 실체가 그라운딩이다.
생성된 문장마다 어떤 문서의 어느 부분을 근거로 삼았는지 되짚을 수 있게 표기하는 것. 문서명·조항·페이지 수준까지 내려갈수록 감사 방어력이 커진다.
💡 '법령 대조·출처 되짚기'의 산출물. 담당자가 근거 문서를 클릭해 원문을 확인할 수 있어야 행정 문서로서 신뢰를 얻는다.
1차 검색으로 넉넉히 뽑은 후보(예: 상위 20개)를, 질의와의 실제 관련성을 더 정밀히 재는 별도 모델로 다시 줄 세워 상위 몇 개만 남기는 단계.
💡 임베딩 검색은 빠르지만 거칠다. 리랭킹으로 '진짜 관련 있는 조항'을 위로 올리면 인용 정확도와 그라운딩이 함께 개선된다.
원본 파일(PDF·한글 HWP·표·스캔본)을 텍스트로 추출·정제하고, 비식별·청킹·임베딩을 거쳐 저장소에 적재하는 앞단 파이프라인 전체.
💡 '서류를 캐비닛에 넣기 전 처리' 공정. 한글 표·스캔 PDF 처리와 비식별 마스킹이 여기서 강제되며, 품질의 대부분이 여기서 결정된다.
저장소의 문서가 최신 개정본인지, 폐지·대체된 자료가 남아있지 않은지 관리하는 것. 각 조각에 출처·시행일·검수일 메타데이터를 붙여 추적한다.
💡 폐지된 법령·지난 지침을 근거로 답하면 최악. 문서 교체만으로 지식을 갱신하는 RAG의 장점을 살리려면 버전 규정이 필수.
문서를 저장소에 넣기 전(그리고 임베딩을 위해 외부로 보내기 전) 주민번호·전화·계좌·이름+주소 조합 등 개인정보를 탐지·마스킹하는 처리.
💡 임베딩·검색도 결국 텍스트를 제3자 API로 보내는 행위일 수 있다. 이 플랫폼의 입력단 PII 스캐너와 서버 재검증(G1)이 인제스션 앞단에 반드시 붙어야 한다.
'이 질문엔 이 문서 조각이 정답 근거'라는 라벨링된 정답셋(golden set)을 만들어, 검색이 실제로 그 근거를 상위에 뽑는지 재현율·정밀도로 측정하는 것.
💡 RAG는 '느낌상 잘 된다'로 검수할 수 없다. eval-eng와 연결해 검색 품질을 수치로 관리해야 개선 여부를 안다.
의미 기반 벡터검색과 정확한 키워드 검색(BM25 등 어휘 검색)을 함께 써서 결과를 합치는 방식. 고유명사·법령번호·사업코드처럼 '정확히 일치해야 하는' 질의를 벡터검색이 놓치는 약점을 보완한다.
💡 행정 문서엔 '제12조', '2024-사업-081' 같은 정확 매칭 대상이 많다. 벡터+키워드 병행이 실무 검색 품질을 눈에 띄게 올린다.
학습 목표
- RAG가 '내 자료를 근거로 답하게 하는 구조'임을 행정 서류철 비유로 설명한다
- AI에 자료를 통째로 붙여넣을 때의 세 위험(창 초과·개인정보 유출·출처 불가)을 든다
- NotebookLM 같은 완성 도구에 문서를 올려 출처가 달린 답을 얻고, 근거를 클릭해 원문과 대조한다
- 답에 출처가 없거나 근거에 없는 내용을 지어냈을 때(환각) 이를 알아채고 반려한다
- PDF·한글·표가 섞인 문서를 텍스트로 정제하고, 조항/절 경계를 살려 청킹한다
- 합성 데이터셋에 심어둔 개인정보를 비식별 처리한 뒤에만 인제스션하도록 순서를 지킨다
- '검색→생성' 파이프라인을 구성해, 근거 밖 질문엔 '자료 없음'으로 답하도록 그라운딩을 건다
- 문장별 출처(문서·조항)를 표기하게 하고, 폐지·개정 문서를 저장소에서 걸러낸다
- 의미검색+키워드검색을 합친 하이브리드 검색과 리랭킹을 붙여 검색 품질을 개선한다
- 라벨링된 검색 정답셋으로 재현율/정밀도를 측정하고, 청킹·K값·리랭킹 변경의 효과를 수치로 비교한다
- 각 조각에 sourceOfTruth·lastLegalReview·riskLevel 메타데이터를 부여해 최신성·감사 추적 체계를 설계한다
- '완성 도구(NotebookLM 등) vs 직접 구축'을 데이터 민감도·망분리·규모·감사요구 기준으로 판단하고 근거를 문서화한다
세션 구성
| 회차 | 주제 | 시수 | 내용 | 산출물 |
|---|---|---|---|---|
| 1 | 왜 붙여넣기는 실패하는가 — RAG의 필요성과 큰 그림 | 1.5h | 통째 붙여넣기의 세 실패(창 초과로 잘림·개인정보의 제3자 전송·출처 되짚기 불가)를 실물로 시연. RAG를 '근거 서류철 정리→법령 대조→출처 되짚기' 3단계에 대응시켜 전체 그림을 그린다. context-eng(무엇을 창에 넣나)와의 역할 분담, 파인튜닝과의 차이(지식을 문서에 두기)를 정리. 이 플랫폼의 안전 게이트 G1~G4가 RAG 어디에 붙는지 지도화. | '내 업무에서 RAG로 풀 문제 3개' 목록 + 각 문제의 근거 문서 후보와 민감도(개인정보 포함 여부) 표 |
| 2 | 문서 수집·정제 — PDF·한글·표 다루기와 비식별 선처리 | 2h | 원본에서 텍스트를 뽑는 인제스션 앞단. 스캔 PDF(이미지)와 텍스트 PDF의 차이, 한글(HWP) 표·별표 처리의 함정, 표를 텍스트로 평탄화할 때 의미가 깨지는 문제를 실습. 핵심 안전 절차: '캐비닛에 넣기 전 검은 테이프', 즉 주민번호·전화·계좌·이름+주소 조합을 비식별(마스킹)한 뒤에만 다음 단계로 넘긴다. 이 플랫폼의 입력단 PII 스캐너(rcp-deidentify 훅)와 순서를 맞춘다. | 합성 문서 1건을 텍스트로 정제 + 비식별 처리한 결과물, 마스킹 전/후 대조표 |
| 3 | 청킹·임베딩·벡터검색 — 색인 체계 만들기 | 2h | 두꺼운 편람에 간지 끼우기(청킹): 문단·조항 경계 존중, 적정 크기, 겹침(overlap). 임베딩='뜻이 비슷하면 같은 서랍', 벡터스토어='서랍 색인', 검색='비슷한 사례철 꺼내기'를 개념+간단 실습으로. 임베딩 생성도 텍스트 반출임을 강조하고, 로컬 저장 vs 관리형 서비스 선택이 망분리와 어떻게 얽히는지 판단 기준 제시. | 동일 문서를 '문단 단위 vs 조항 단위'로 각각 청킹해 검색 결과가 어떻게 달라지는지 비교 메모 |
| 4 | 검색→생성 파이프라인 — 그라운딩과 출처 표기 | 2h | 검색된 근거만으로 답하고, 근거에 없으면 '자료 없음'이라 답하게 하는 그라운딩 프롬프트 설계. 문장별 출처(문서명·조항·페이지) 표기를 강제하고, 담당자가 원문을 클릭해 대조하는 흐름. 환각이 새는 전형(질문이 근거 밖일 때, 근거가 부실할 때)을 재현하고 반려. 안전 게이트 G3의 실체를 손으로 만든다. | '근거 안 질문'과 '근거 밖 질문' 각 3개에 대해, 출처가 달린 답 vs 자료없음 응답이 올바르게 갈리는 실행 로그 |
| 5 | 검색 품질 평가·하이브리드·리랭킹 — 심화(L3) | 2h | '느낌상 잘됨'을 수치로: 라벨링된 검색 정답셋으로 재현율/정밀도 측정(eval-eng 연결). 벡터검색이 '제12조'·'2024-사업-081' 같은 정확매칭을 놓치는 약점을 하이브리드 검색으로 보완, 리랭킹으로 상위 정렬 개선. 각 변경(청킹 크기·상위 K·리랭킹)의 효과를 정답셋으로 A/B 비교. | 20문항 규모 검색 정답셋 + 변경 전/후 재현율·정밀도 비교표 |
| 6 | 최신성·버전 관리, 도구 선택, 부서 배포 | 1.5h | 폐지·개정 문서를 저장소에서 빼는 규정, 조각별 메타데이터(sourceOfTruth·lastLegalReview·riskLevel)로 감사 추적. '완성 도구(NotebookLM 등) vs 직접 구축' 판단표(데이터 민감도·망분리·규모·감사요구·유지보수 역량). 고위험 콘텐츠(법령·계약·인사)는 소관부서·법무 사인오프 게이트. 부서 배포용 표준 절차와 체크리스트로 마무리. | 우리 부서 RAG 도입 판단서(도구 선택 근거+최신성 규정+비식별/사인오프 게이트가 포함된 1~2쪽 문서) |
실습 랩
랩 A — 합성 편람으로 만드는 '출처 달린 민원 답변봇'
목표 · NotebookLM(또는 이 플랫폼의 문서 업로드 실습)에 합성 업무편람을 올려, 출처가 달린 답을 얻고 근거를 원문과 대조하는 RAG 기본 흐름을 체득한다. 실제 자료 반입 없이 합성 데이터셋만 사용.
- 플랫폼이 제공하는 합성 '주차 민원 업무편람'(가짜 조항·가짜 사례 포함) 파일을 준비한다. 실제 청사 문서는 절대 사용하지 않는다.
- 2세션 절차대로 문서에 개인정보 자리표시자가 있는지 훑고, 있으면 비식별(마스킹)한 버전을 만든다.
- 비식별본을 NotebookLM(또는 플랫폼 업로드 실습창)에 올린다. 망분리 청사라면 오프라인 워크북의 모의 실습 경로로 대체한다.
- '거주자 우선주차 신청 자격이 뭔가요?'처럼 편람 안에 답이 있는 질문 3개를 던지고, 답마다 달린 출처를 클릭해 편람 원문 조항과 한 글자씩 대조한다.
- '옆 동네 시청 주차요금은?'처럼 편람 밖 질문 3개를 던져, 도구가 '자료 없음'이라 답하는지(그라운딩) 확인한다. 지어내면 환각으로 기록한다.
- 환각·출처 오류가 난 사례를 캡처해 '왜 샜는가(근거 부실/질문이 범위 밖)'를 한 줄로 적는다.
✅ 성공 기준 · 근거 안 질문 3개는 모두 원문과 일치하는 출처가 달렸고, 근거 밖 질문 3개는 지어내지 않고 '자료 없음'으로 응답했다. 비식별을 거친 파일만 업로드했다.
↗ 확장 · 편람의 한 조항을 개정본으로 바꿔 다시 올린 뒤, 같은 질문에 답이 최신 조항으로 갱신되는지 확인한다(최신성 체감).
랩 B — 청킹·하이브리드·정답셋으로 검색 품질 끌어올리기(L3)
목표 · 동일 문서를 서로 다르게 청킹하고, 하이브리드 검색·리랭킹을 붙였을 때 검색 품질이 실제로 오르는지 정답셋으로 수치 비교한다.
- 합성 편람에 대해 '질문→정답 근거 조항' 쌍 20개를 라벨링해 검색 정답셋(golden set)을 만든다.
- 같은 문서를 (1)고정 길이 조각 (2)조항 경계 존중 조각 두 방식으로 청킹해 각각 색인한다.
- 각 색인에서 정답셋을 돌려 상위 K개 안에 정답 근거가 들어오는 비율(재현율)과 정밀도를 계산해 표로 적는다.
- '제12조', '2024-사업-081' 같은 정확매칭 질문을 정답셋에 섞고, 벡터검색 단독 vs 하이브리드(키워드 병행) 결과를 비교한다.
- 리랭킹을 켜고 끈 두 조건에서 상위 3개의 정밀도를 다시 비교한다.
- 가장 좋은 조합(청킹·K·하이브리드·리랭킹)을 고르고 근거를 3줄로 정리한다.
✅ 성공 기준 · 두 청킹 방식과 하이브리드 on/off, 리랭킹 on/off의 재현율·정밀도가 한 표에 정리되고, 최적 조합 선택 근거가 정답셋 수치로 뒷받침된다.
↗ 확장 · 정답셋을 40문항으로 늘리고, 상위 K를 3·5·10으로 바꿨을 때 재현율/정밀도의 트레이드오프 곡선을 그린다.
사례 연구
상황 · 한 기초자치단체가 복지 상담 안내를 빠르게 하려고, 과거 상담일지 묶음을 그대로 문서저장소에 넣고 RAG 안내봇을 만들었다(합성·재구성 사례).
상담일지에는 신청인 이름·주민번호·질병 정보가 원문 그대로 남아 있었다. 저장 과정에서 임베딩을 위해 문서가 외부 API로 전송됐고, 이후 안내봇이 다른 민원인에게 답하면서 유사 사례를 검색해 '○○○님은 이러이러한 지원을 받았다'는 식으로 특정 개인의 민감정보를 노출했다. 뿌리 원인은 두 가지다. (1)인제스션 앞단에 비식별 선처리가 없어 개인정보가 색인에 그대로 들어갔고, (2)그라운딩이 '검색된 근거를 그대로 인용'하도록만 걸려 있어 민감정보 필터가 없었다. 올바른 순서는 '비식별(마스킹)→청킹→임베딩→저장'이며, 이 플랫폼의 입력단 PII 스캐너와 서버측 재검증(G1)이 인제스션 앞단에 강제로 붙어야 한다. 또한 임베딩·검색이 곧 '텍스트의 제3자 전송'임을 인지하고, 민감 문서는 로컬 저장·망분리 경로를 택했어야 한다.
교훈 · RAG의 위험은 '생성' 단계가 아니라 '인제스션' 앞단에서 이미 결정된다. 비식별은 프롬프트 문구가 아니라 파이프라인 훅으로 강제하라. 임베딩=반출이다.
상황 · 한 조직이 사내 규정·지침 수백 건을 저장소에 넣고 규정 질의응답 챗봇을 운영했다.
규정이 개정됐는데 구버전 문서를 저장소에서 빼지 않아, 챗봇이 폐지된 조항과 신규 조항을 함께 검색해 옛 기준으로 답했다. 출처는 달려 있었지만 '어느 것이 현행인가'를 구분하는 메타데이터가 없어, 사용자는 출처를 봐도 최신 여부를 알 수 없었다. 해결은 조각마다 시행일·검수일·현행 여부(sourceOfTruth·lastLegalReview) 메타데이터를 부여하고, 인제스션 시 폐지본을 색인에서 제외하거나 '폐지' 태그로 낮은 우선순위를 주는 것이었다. 하이브리드 검색으로 규정번호 정확매칭을 강화하니 '제몇조'를 정확히 찾는 정밀도도 함께 올랐다.
교훈 · 출처 표기만으로는 부족하다. '현행 여부'까지 되짚을 수 있어야 감사에서 방어된다. 최신성은 문서 교체 규정+메타데이터로 관리하라.
흔한 실패 · 안티패턴
- 통째 붙여넣기: 문서를 프롬프트에 그대로 넣으면 창 초과로 잘리고 출처를 되짚을 수 없다. RAG는 '필요한 조각만' 넣는 것.
- 비식별을 나중으로 미룸: 임베딩·검색도 텍스트의 제3자 전송이다. 마스킹은 인제스션 맨 앞에서 강제해야 하며, 순서(비식별→청킹→임베딩)를 지켜야 한다.
- 청킹 방치: 고정 길이로 무심코 자르면 조항이 문장 중간에서 끊겨 인용이 엉킨다. 행정 서식(조·항·별표·절) 경계를 살려라.
- 그라운딩 미설정: '근거 밖이면 자료 없음이라 답하라'를 명시하지 않으면 모델은 빈틈을 지어낸다(환각). 근거 밖 질문 테스트를 반드시 포함.
- 출처=신뢰 착각: 출처가 달려도 그 문서가 폐지본일 수 있다. 현행 여부·시행일 메타데이터가 없으면 최신성 사고가 난다.
- 벡터검색 만능 착각: 의미검색은 '제12조'·사업코드 같은 정확매칭을 놓친다. 하이브리드(키워드 병행)로 보완하라.
- 평가 없이 개선 주장: '느낌상 좋아졌다'는 검수가 아니다. 라벨링된 정답셋으로 재현율/정밀도를 재지 않으면 무엇이 나아졌는지 알 수 없다.
- 도구 선택 근거 부재: 데이터 민감도·망분리·감사요구를 따지지 않고 유행하는 완성 도구에 민감 자료를 올리면, 편의가 곧 유출 경로가 된다.
- 고위험 콘텐츠 무검수 배포: 법령·계약·인사 답변은 환각 시 법적 리스크가 최대. 소관부서·법무 사인오프 게이트 없이 배포하지 말 것.
평가
| 평가 기준 | 초급 | 능숙 | 전문 |
|---|---|---|---|
| 인제스션·비식별 순서 준수 | 문서를 정제·비식별 없이 그대로 올린다. 개인정보가 색인에 들어갈 위험을 인지하지 못한다. | 비식별→청킹→임베딩 순서를 지키고, 합성 데이터만 사용한다. 마스킹 전/후를 대조할 수 있다. | 임베딩=반출임을 전제로 민감도에 따라 로컬/망분리 경로를 택하고, 비식별을 파이프라인 훅(서버 재검증 포함)으로 강제하는 설계를 제시한다. |
| 청킹·검색 품질 | 고정 길이로 무심코 자르고, 검색 결과의 좋고 나쁨을 판단하지 못한다. | 조항/절 경계를 살려 청킹하고, 검색 결과를 원문과 대조해 관련성을 판단한다. | 하이브리드·리랭킹을 적용하고, 라벨링된 정답셋으로 재현율/정밀도를 측정해 청킹·K·리랭킹 변경 효과를 수치로 비교한다. |
| 그라운딩·출처·환각 억제 | 근거 밖 질문에도 그럴듯한 답을 받아 그대로 쓴다. 출처를 확인하지 않는다. | 근거 안/밖 질문을 구분해 테스트하고, 출처를 원문과 대조하며 환각을 반려한다. | 문장별 출처(문서·조항)를 강제하고 '자료 없음' 응답을 설계하며, 환각이 새는 조건을 재현·차단하는 절차를 만든다. |
| 최신성·거버넌스·도구 판단 | 폐지·개정 여부를 관리하지 않고, 도구 선택 근거가 없다. | 폐지본을 걸러내고 현행 여부를 확인하며, 도구 선택 시 데이터 민감도를 고려한다. | 조각별 sourceOfTruth·lastLegalReview·riskLevel 메타데이터로 감사 추적을 설계하고, 완성도구 vs 직접구축을 다기준으로 판단하며 고위험 콘텐츠에 사인오프 게이트를 건다. |
- AI에게 답을 시킬 때, 참고할 문서를 통째로 프롬프트에 붙여넣으면 생길 수 있는 문제를 아는 대로 적으시오.
- '출처가 달린 답'과 '출처 없는 답' 중 어느 것을 행정 문서에 쓸 수 있는지, 그 이유는?
- 내가 가진 상담일지를 AI 도구에 올려 안내봇을 만들려 한다. 올리기 전에 반드시 해야 할 처리는 무엇인가?
- 'AI가 폐지된 규정으로 답했다'는 사고를 막으려면 문서 저장소를 어떻게 관리해야 하는가?
- RAG의 4단계(인제스션·청킹/임베딩·검색·그라운딩 생성)를 행정 서류철 비유로 각 1문장씩 설명하시오.
- 합성 편람으로 만든 안내봇이 편람 밖 질문에 '자료 없음'이라 답하도록 만드는 그라운딩 방법과, 그것을 검증할 테스트 설계를 쓰시오.
- 벡터검색만으로 '제12조'를 잘 못 찾는 이유와, 하이브리드 검색이 이를 어떻게 보완하는지 설명하시오.
- 검색 정답셋 20문항으로 청킹 방식 A/B의 재현율·정밀도를 비교하는 절차를 서술하고, '개선됐다'를 주장하려면 어떤 수치가 필요한지 쓰시오.
- 민감한 복지 상담 자료를 근거로 RAG를 만들 때, 완성 도구 대신 직접 구축(또는 망분리 경로)을 택해야 하는 판단 기준 3가지를 제시하시오.
읽을거리 · 도구
- 검색증강생성(RAG) 원 개념 논문 — 'Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks' — RAG라는 용어와 구조의 출발점 (왜 읽나: '지식을 모델 안에 우겨넣지 말고 외부 문서에서 검색해 붙인다'는 발상의 근거를 원전에서 확인하기 위해. 세부 수식보다 '검색+생성 결합'의 동기와 한계 논의를 읽을 것. 정확한 저자·출판처는 검색해 원문을 확인하라(임의 인용 금지).)
- 자신이 쓰는 LLM 도구의 공식 문서 중 '문서 기반 답변/파일 업로드·근거 표시' 항목 — 실제 사용할 도구가 근거를 어떻게 검색·표기하는지 (왜 읽나: 도구마다 청킹·출처 표기·데이터 처리(전송·보관) 정책이 다르다. 특히 '업로드한 자료가 어디로 가고 얼마나 보관되는가'를 확인해 비식별·망분리 판단의 근거로 삼기 위해. 버전은 바뀌므로 항상 현행 공식 문서에서 검증할 것.)
- NotebookLM 등 '내 문서 기반' 완성 도구의 데이터 처리·개인정보 안내 페이지 — 완성 도구를 쓸 때의 데이터 반출·보관 실체 (왜 읽나: '직접 구축 vs 완성 도구' 판단은 편의가 아니라 데이터가 어디로 가느냐로 갈린다. 실제 문구를 읽고 민감 자료 적용 가능 여부를 스스로 판정하기 위해.)
- 개인정보보호위원회의 '가명·익명처리(비식별) 관련 안내·가이드라인' — 행정에서 통용되는 비식별 처리의 기준·절차 (왜 읽나: 이 모듈의 비식별 선처리는 감(感)이 아니라 공식 기준을 따라야 한다. 어디까지 마스킹해야 재식별 위험이 낮은지 판단 근거를 확보하기 위해. 최신 개정본을 공식 사이트에서 확인하라.)
- 이 플랫폼 커리큘럼 §5.5·§14 — 안전 입력단(PII 스캐너·서버 재검증)과 저작·법령 사인오프 — 이 모듈의 안전 게이트가 실제 코드/운영에서 어떻게 강제되는지 (왜 읽나: RAG 실습의 비식별·최신성·사인오프가 추상 원칙이 아니라 이 플랫폼의 실제 게이트(G1~G4)와 정합함을 확인하기 위해.)