앞의 네 겹(프롬프트·컨텍스트·하네스·헤르메스)을 데이터로 다뤄 측정·개선·제도화하는 가장 바깥 계층 — 무엇이 '좋은 결과'인지 정의하고, 하위 계층을 재현 가능하게 개선하며, 조직의 표준·거버넌스로 재생산한다.
4컷으로 보기 — 기획
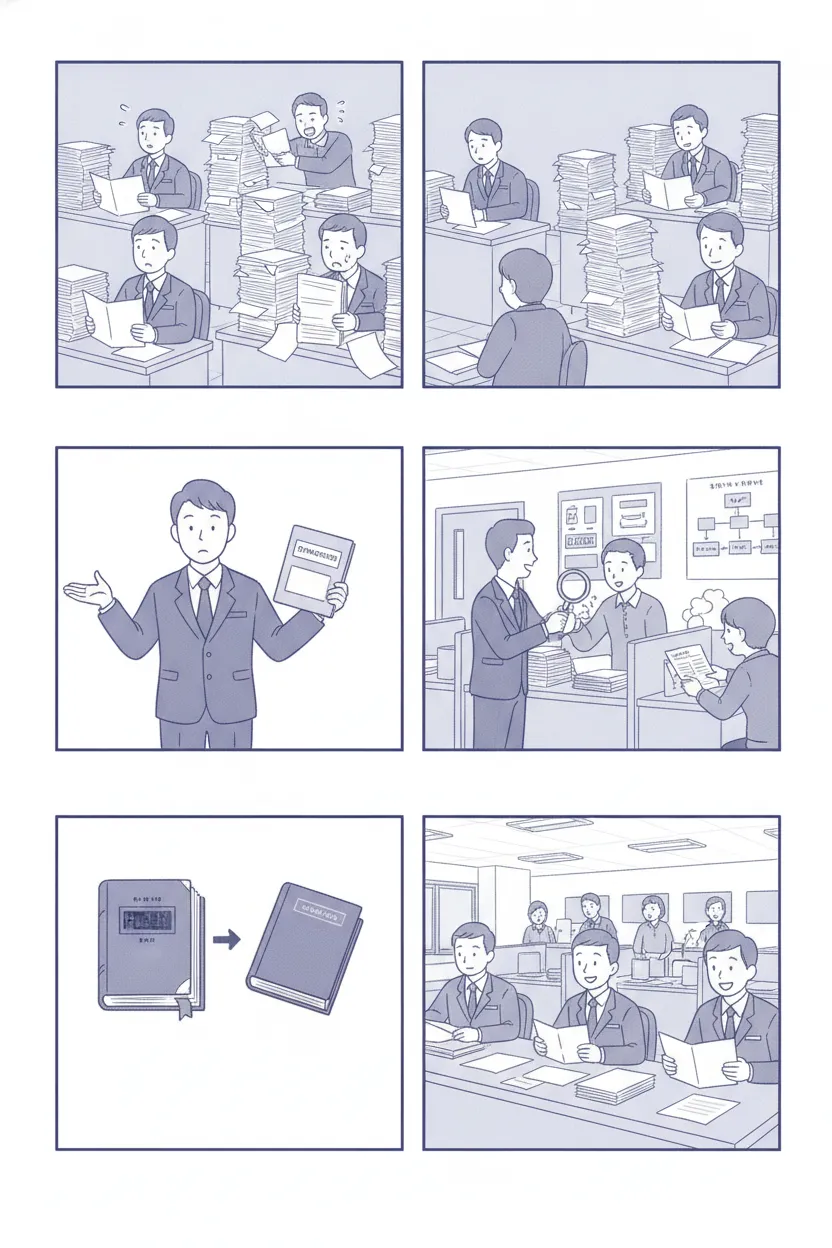
- 11컷: 각자 다르게 일하는 민원 창구, 뒤죽박죽 서류더미
- 22컷: 기획감사부서 등장, 업무매뉴얼과 품질점검표 펼치기
- 33컷: 매뉴얼·서식 표준화하고 정기감사로 오류 잡아내기
- 44컷: 법령 개정에 맞춰 서식 일제 갱신, 안정적인 민원창구 완성
왜 중요한가
한 번 잘 만든 AI 시스템도 모델 교체·업무 변화·규정 개정에 따라 낡는다. 메타는 무엇이 좋은 결과인지 평가로 정의하고, 그 기준으로 하위 계층을 재현 가능하게 개선하며, 개인기를 조직 표준·거버넌스로 재생산해 시스템의 지속가능성을 책임진다.
행정 실무 비유
기획·감사 부서가 하는 일과 같다. 개별 담당자가 민원을 잘 처리하는 것을 넘어, 잘 처리하는 방식을 '업무 매뉴얼'로 성문화하고, 표준서식과 위임전결 규정 자체를 주기적으로 개정하며, 품질관리·감사를 돌려 규정대로 굴러가는지 점검한다. 법령이 개정되면(=모델 교체) 관련 서식과 업무흐름을 일제히 갱신하고, 사고가 나면 회고해 재발방지 지침을 매뉴얼에 반영한다. 메타 엔지니어링은 프롬프트·컨텍스트·하네스·인터페이스에 대해 바로 이 '매뉴얼 개정 + 품질·감사 + 표준화 교육' 기능을 수행한다.
🖐 실무 따라하기 — 복붙해서 따라 하면 됩니다
- 1실습 폴더 만들고 파이썬 확인
터미널을 열고 아래를 통째로 붙여넣어 실행한다. 실습 폴더를 만들고 파이썬 버전을 확인한다(3.10 이상이면 OK). 외부 설치·인터넷 불필요, 표준 라이브러리만 쓴다.
터미널 명령mkdir -p /home/gdi-s2/dev/aiedu/meta-eng-lab && cd /home/gdi-s2/dev/aiedu/meta-eng-lab && python3 --version && echo 'OK: 폴더 준비됨'
→ 결과 'Python 3.12.3' 같은 버전 문자열(3.10 이상이면 정상)과 'OK: 폴더 준비됨'이 출력된다. 'command not found'가 나오면 python3 대신 python 으로 바꿔 재실행.
- 2골든 데이터셋 20건 작성(무엇이 정답인가를 못박기)
아래 명령을 통째로(맨 끝 wc -l 줄까지) 붙여넣어 golden.jsonl을 만든다. 한 줄=한 민원=정답 한 세트다. 모두 합성 데이터. 이 파일이 '좋은 결과의 정의'이자 이후 모든 심사의 기준선(회귀 테스트의 진실)이 된다. 함정으로 MW-2026-0012('수도관 파열'인데 문장에 '도로' 단어가 섞임 → 정답은 상하수도)와 MW-2026-0018(폭언 포함, 정답은 복지/중)을 일부러 넣었다. 맨 끝의 wc -l 명령이 저장 결과를 화면에 출력해준다.
터미널 명령cat > /home/gdi-s2/dev/aiedu/meta-eng-lab/golden.jsonl << 'EOF' {"id":"MW-2026-0001","text":"우리 동네 도로에 포트홀이 생겨서 차 바퀴가 빠질 뻔했어요","dept":"도로","urgency":"상"} {"id":"MW-2026-0002","text":"수도꼭지에서 녹물이 나옵니다 마셔도 되나요","dept":"상하수도","urgency":"중"} {"id":"MW-2026-0003","text":"공원 벤치 옆에 쓰레기 무단투기가 심해요","dept":"환경","urgency":"하"} {"id":"MW-2026-0004","text":"기초생활수급 신청 서류가 어떤 게 필요한지 알려주세요","dept":"복지","urgency":"하"} {"id":"MW-2026-0005","text":"횡단보도 신호등이 꺼져서 사고 날 뻔했습니다 빨리 조치해주세요","dept":"도로","urgency":"상"} {"id":"MW-2026-0006","text":"하수구가 막혀서 물이 역류하고 악취가 납니다","dept":"상하수도","urgency":"상"} {"id":"MW-2026-0007","text":"야산에 폐기물을 태우는 연기가 자욱해요","dept":"환경","urgency":"중"} {"id":"MW-2026-0008","text":"독거 어르신 안부확인 서비스 신청하고 싶어요","dept":"복지","urgency":"중"} {"id":"MW-2026-0009","text":"인도 보도블럭이 깨져서 어르신이 넘어졌어요","dept":"도로","urgency":"상"} {"id":"MW-2026-0010","text":"단수 안내 문자를 못 받았는데 언제 물이 나오나요","dept":"상하수도","urgency":"중"} {"id":"MW-2026-0011","text":"길고양이 급식소 위생 관리가 안 돼요","dept":"환경","urgency":"하"} {"id":"MW-2026-0012","text":"수도관이 터져서 도로가 물바다가 됐고 차가 못 지나가요","dept":"상하수도","urgency":"상"} {"id":"MW-2026-0013","text":"장애인 콜택시 예약이 계속 안 됩니다","dept":"복지","urgency":"중"} {"id":"MW-2026-0014","text":"가로등이 며칠째 꺼져 있어 밤에 위험합니다","dept":"도로","urgency":"중"} {"id":"MW-2026-0015","text":"음식점 기름냄새와 매연으로 창문을 못 엽니다","dept":"환경","urgency":"중"} {"id":"MW-2026-0016","text":"상수도 요금이 갑자기 두 배로 나왔어요 확인 부탁해요","dept":"상하수도","urgency":"하"} {"id":"MW-2026-0017","text":"아동수당 지급일이 지났는데 입금이 안 됐어요","dept":"복지","urgency":"중"} {"id":"MW-2026-0018","text":"담당 공무원이 불친절했다 당장 바꿔라 이 무능한 것들아","dept":"복지","urgency":"중"} {"id":"MW-2026-0019","text":"산사태 위험지역에 균열이 커지고 있어요 위급합니다","dept":"환경","urgency":"상"} {"id":"MW-2026-0020","text":"도로 표지판이 넘어져서 방향을 알 수 없어요","dept":"도로","urgency":"하"} EOF wc -l /home/gdi-s2/dev/aiedu/meta-eng-lab/golden.jsonl→ 결과 맨 끝 wc -l 명령이 실행되어 '20 /home/gdi-s2/dev/aiedu/meta-eng-lab/golden.jsonl'이 출력되면 성공(정확히 20줄). 각 줄은 민원 원문(text)과 사람이 합의한 정답(dept 담당부서, urgency 긴급도)을 담는다. 함정 정답 확인: MW-2026-0012의 dept는 '상하수도'(문장에 '도로' 단어가 있어도 원인 시설이 수도관이므로), MW-2026-0018의 urgency는 '중'(폭언이지만 실제 처리 시급성은 중). 이 정답 세트가 앞으로 바뀌지 않는 '기준'이다.
- 3예측기(predict.py) 만들기 — 프롬프트 v1/v2를 코드로 고정
아래를 EOF 줄까지 통째로 붙여넣어 predict.py를 만들고 v1·v2를 실행한다. 실제 LLM 호출 대신 '프롬프트 규칙'을 파이썬 함수로 재현한 가짜 모델이다(외부 전송·API키 없이 회귀 파이프라인 전체를 체험하는 용도). 규칙은 위→아래 순서로 dept를 덮어쓴다(아래에 걸리는 규칙이 이긴다). v1은 현행 규칙으로, '도로' 규칙이 맨 아래라 누수(수도관) 민원에 '도로' 단어가 섞이면 상하수도→도로로 잘못 덮어써진다(MW-2026-0012 오분류). v2는 '수도관/역류는 도로 단어가 있어도 상하수도로 확정'하는 개선 규칙을 맨 마지막에 추가한 안이다. 실제 운영에선 predict() 내부만 OpenAI/Claude API 호출로 바꾸면 나머지 채점·판정 로직은 그대로 재사용된다.
코드cat > /home/gdi-s2/dev/aiedu/meta-eng-lab/predict.py << 'EOF' import sys, json, os # 실제 운영에서는 이 predict() 내부를 LLM API 호출로 교체한다. # 여기서는 API키/외부전송 없이 '프롬프트 규칙'을 파이썬으로 재현한 가짜 모델. # 규칙은 위->아래 순서로 dept를 덮어쓴다(아래에 걸리는 규칙이 이긴다). def predict(text, version): t = text dept = "복지" # 기본값 if any(k in t for k in ["녹물","하수","단수","상수도","수도요금","수도관","수도꼭지"]): dept = "상하수도" if any(k in t for k in ["쓰레기","무단투기","폐기물","연기","매연","악취","고양이","산사태","균열"]): dept = "환경" if any(k in t for k in ["수급","안부","콜택시","아동수당","장애인"]): dept = "복지" # v1의 함정: '도로' 규칙이 맨 아래라, 누수(수도관) 민원에 '도로' 단어가 섞이면 # 상하수도->도로로 덮어써져 MW-2026-0012가 '도로'로 오분류된다. if any(k in t for k in ["포트홀","도로","신호등","보도블럭","인도","가로등","표지판"]): dept = "도로" # v2 개선 규칙: 수도관 파열/역류는 '도로' 단어가 섞여도 상하수도로 확정(함정 MW-2026-0012 교정) if version == "v2" and ("수도관" in t or "역류" in t): dept = "상하수도" # --- 긴급도 --- urgency = "하" if any(k in t for k in ["위험","위급","사고","터져","역류","넘어졌","빠질 뻔"]): urgency = "상" elif any(k in t for k in ["악취","매연","안 됩니다","안 됐","못","꺼져"]): urgency = "중" return {"dept": dept, "urgency": urgency} if __name__ == "__main__": version = sys.argv[1] if len(sys.argv) > 1 else "v1" base = os.path.dirname(os.path.abspath(__file__)) out = [] for line in open(f"{base}/golden.jsonl", encoding="utf-8"): row = json.loads(line) p = predict(row["text"], version) out.append({"id": row["id"], "dept": p["dept"], "urgency": p["urgency"]}) with open(f"{base}/pred_{version}.jsonl", "w", encoding="utf-8") as f: for r in out: f.write(json.dumps(r, ensure_ascii=False) + " ") print(f"{version}: {len(out)}건 예측 -> pred_{version}.jsonl") EOF cd /home/gdi-s2/dev/aiedu/meta-eng-lab && python3 predict.py v1 && python3 predict.py v2→ 결과 'v1: 20건 예측 -> pred_v1.jsonl'과 'v2: 20건 예측 -> pred_v2.jsonl' 두 줄이 출력된다. 폴더에 pred_v1.jsonl, pred_v2.jsonl 두 파일이 생긴다. 무설치 대안: /playground나 ChatGPT·Claude 웹에 다음 프롬프트를 붙여넣어도 된다 — '아래 20개 민원을 각각 {"id":..., "dept":"도로|상하수도|환경|복지", "urgency":"상|중|하"} 형식 JSONL로 분류해줘. 설명 없이 20줄만 출력.' + golden.jsonl 내용 붙여넣기(합성 데이터라 안전). 그 결과를 pred_v1.jsonl로 저장하면 동일하게 진행 가능.
- 4자동 채점·회귀 리포트(score.py) — 조용한 악화를 잡아낸다
아래를 EOF 줄까지 통째로 붙여넣어 score.py를 만들고 실행한다. 골든셋 정답과 v1·v2 예측을 대조해 부서정확도·긴급도정확도를 계산하고, 핵심으로 '회귀 건수'(v1은 부서·긴급도 둘 다 맞혔는데 v2가 하나라도 틀린 건)를 센다. 회귀 0건이고 v2 성적이 v1 이상이면 PASS, 회귀 1건 이상이면 FAIL로 자동 판정한다. 이게 모델교체 거버넌스의 게이트다.
코드cat > /home/gdi-s2/dev/aiedu/meta-eng-lab/score.py << 'EOF' import json, os base = os.path.dirname(os.path.abspath(__file__)) def load(path): return {json.loads(l)["id"]: json.loads(l) for l in open(path, encoding="utf-8")} gold = load(f"{base}/golden.jsonl") v1 = load(f"{base}/pred_v1.jsonl") v2 = load(f"{base}/pred_v2.jsonl") def acc(pred, field): ok = sum(1 for i in gold if pred[i][field] == gold[i][field]) return ok, len(gold) def report(pred, name): d_ok, n = acc(pred, "dept"); u_ok, _ = acc(pred, "urgency") both = sum(1 for i in gold if pred[i]["dept"]==gold[i]["dept"] and pred[i]["urgency"]==gold[i]["urgency"]) print(f"[{name}] 부서정확도 {d_ok}/{n}({d_ok/n:.0%}) 긴급도정확도 {u_ok}/{n}({u_ok/n:.0%}) 둘다맞음 {both}/{n}") return both print("="*56) b1 = report(v1, "v1 현행"); b2 = report(v2, "v2 신규") # 회귀: v1은 (부서·긴급도 둘 다) 맞았는데 v2가 하나라도 틀린 건 regress = [] for i in gold: v1_ok = v1[i]["dept"]==gold[i]["dept"] and v1[i]["urgency"]==gold[i]["urgency"] v2_ok = v2[i]["dept"]==gold[i]["dept"] and v2[i]["urgency"]==gold[i]["urgency"] if v1_ok and not v2_ok: regress.append((i, gold[i]["text"][:24], v2[i])) print("-"*56) print(f"회귀(정답->오답 뒤집힘): {len(regress)}건") for i, t, p in regress: print(f" X {i} '{t}...' -> v2예측 {p['dept']}/{p['urgency']} (정답 {gold[i]['dept']}/{gold[i]['urgency']})") verdict = "PASS" if len(regress)==0 and b2>=b1 else "FAIL" print("="*56) print(f"판정: {verdict} (v1 둘다맞음 {b1} -> v2 {b2}, 회귀 {len(regress)})") EOF cd /home/gdi-s2/dev/aiedu/meta-eng-lab && python3 score.py→ 결과 아래 표가 그대로 찍힌다: '[v1 현행] 부서정확도 18/20(90%) 긴급도정확도 15/20(75%) 둘다맞음 13/20' / '[v2 신규] 부서정확도 20/20(100%) 긴급도정확도 15/20(75%) 둘다맞음 15/20'. v1이 부서 18/20인 이유는 함정 MW-2026-0006('하수구...역류')·MW-2026-0012('수도관...도로')를 오분류하기 때문이고, v2가 20/20으로 둘 다 교정한다. 맨 아래 '회귀(정답->오답 뒤집힘): 0건'과 '판정: PASS (v1 둘다맞음 13 -> v2 15, 회귀 0)'가 뜨면 정상. 이 한 화면이 '교체해도 되는가'의 근거다.
- 5교체 판정표(report.md) 남기고 회귀를 일부러 일으켜 게이트 검증
먼저 판정 결과를 report.md로 저장한다(거버넌스 기록·버전관리 대상). 그다음 v2에 나쁜 규칙을 한 줄 심어 일부러 회귀를 만들고 재심사해서 게이트가 정말 FAIL을 잡는지 확인한 뒤, 원복한다. '테스트가 실패를 잡는지 테스트'하는 단계다. 아래를 통째로 붙여넣어 실행한다.
터미널 명령cd /home/gdi-s2/dev/aiedu/meta-eng-lab # 1) 현재 판정을 기록으로 남김 { echo "# 모델교체 심사 리포트 (2026-07-07)"; echo; echo '## 대상: 민원 분류 프롬프트 v1 -> v2'; echo '## 골든셋: golden.jsonl (합성 20건)'; echo; echo '```'; python3 score.py; echo '```'; } > report.md echo '--- report.md 저장 완료 ---' # 2) 일부러 회귀 유발: v2에서 '어르신' 언급을 무조건 복지로 끌어가는 나쁜 규칙 주입 cp predict.py predict.py.bak python3 - << 'PY' s=open('predict.py',encoding='utf-8').read() bad=' if version == "v2" and "어르신" in t: dept = "복지" # 나쁜규칙: 도로/환경의 어르신 언급까지 복지로 끌어감 return {"dept": dept, "urgency": urgency}' s=s.replace(' return {"dept": dept, "urgency": urgency} if __name__',bad+' if __name__',1) open('predict.py','w',encoding='utf-8').write(s) print('나쁜 규칙 주입 완료') PY python3 predict.py v2 && echo '=== 회귀 유발 후 재심사 ===' && python3 score.py # 3) 원복 cp predict.py.bak predict.py && python3 predict.py v2 >/dev/null && echo '--- 원복 완료: predict.py 정상 ---'→ 결과 report.md가 PASS 근거와 함께 저장된다('report.md 저장 완료' 출력). 나쁜 규칙 주입 후 재심사에서는 정확히 'X MW-2026-0009 인도 보도블럭이 깨져서 어르신이 넘어졌어요... -> v2예측 복지/상 (정답 도로/상)'가 나열되고 '회귀(정답->오답 뒤집힘): 1건', '판정: FAIL (v1 둘다맞음 13 -> v2 14, 회귀 1)'이 뜬다 — 도로 민원(어르신이 넘어진)이 복지로 뒤집힌 걸 게이트가 실제로 잡아냄을 눈으로 확인. 마지막에 '원복 완료: predict.py 정상'이 출력되면 predict.py는 다시 PASS 상태(다시 python3 score.py 하면 회귀 0건/PASS).
- 6실패 회고 -> 레시피 자산화(RECIPE-0001.md)
방금 잡아낸 실패(함정 MW-2026-0012 오분류 + 나쁜 규칙으로 인한 MW-2026-0009 회귀)를 조직 자산으로 남긴다. 아래를 EOF 줄까지 통째로 붙여넣어 레시피 카드를 만든다. 다음 담당자가 같은 실수를 반복하지 않도록 '증상->원인->재발방지 규칙->회귀 테스트 추가' 형식으로 성문화한다. 이게 레시피 대장의 1번 항목이 된다.
터미널 명령cat > /home/gdi-s2/dev/aiedu/meta-eng-lab/RECIPE-0001.md << 'EOF' # RECIPE-0001: 민원 분류 프롬프트 회귀 방지 카드 작성일 2026-07-07 | 담당 도민안전실 | 대상 민원 분류 프롬프트 v1->v2 ## 증상 - 수도관 파열 민원(MW-2026-0012)이 '도로'로 오분류됨(문장에 '도로' 단어가 섞여 '도로' 규칙이 상하수도를 덮어씀). v1 부서정확도 18/20. - v2에서 부서 규칙을 무리하게 확장('어르신'->복지)하니, 어르신이 넘어진 도로 민원(MW-2026-0009)이 '복지'로 뒤집힘(회귀 1건 -> FAIL). ## 원인 - 키워드가 여러 부서에 걸치는 복합 민원(누수+도로)의 우선순위 규칙 부재 -> 뒤에 걸린 규칙이 앞 정답을 덮어씀. - 개선 규칙을 '넓게' 넣어 다른 정답을 깨뜨림 -> 조용한 악화(회귀). ## 재발방지 규칙(레시피) 1. 복합 민원은 '원인 시설' 기준으로 배정한다: 수도관/역류 언급 시 '도로' 단어가 있어도 상하수도(v2가 이 규칙을 맨 마지막에 두어 교정). 2. 프롬프트/규칙 변경은 반드시 golden.jsonl 회귀 테스트를 통과(회귀 0건)해야 배포한다. 3. 함정 케이스는 골든셋에 영구 보존한다(MW-2026-0012 복합 누수, MW-2026-0018 폭언). ## 회귀 테스트 추가 - golden.jsonl에 MW-2026-0012, MW-2026-0018 유지. 새 실패 발견 시 골든셋에 1건씩 append 후 python3 score.py 재실행. ## 롤백 절차 - FAIL 판정 시 predict.py(운영에선 프롬프트/모델 설정)를 직전 버전으로 cp 원복, score.py로 PASS 재확인 후에만 유지. ## 레시피 대장 등록 - ID RECIPE-0001 | 상태 적용 | 다음 리뷰 모델 교체 시 EOF cat /home/gdi-s2/dev/aiedu/meta-eng-lab/RECIPE-0001.md && echo && ls -1 /home/gdi-s2/dev/aiedu/meta-eng-lab→ 결과 RECIPE-0001.md 내용이 그대로 출력되고, 이어서 폴더 목록에 golden.jsonl, predict.py, predict.py.bak, score.py, report.md, RECIPE-0001.md, pred_v1.jsonl, pred_v2.jsonl가 보인다. 이제 다음 모델 교체 때는 'predict() 내부만 새 모델 호출로 바꾸고 python3 score.py 한 줄'로 회귀를 재심사할 수 있다 — 측정·게이트·회고가 제도화된 상태.
스택 내 위치
AI 엔지니어링 스택의 다섯 번째(⑤)이자 최외곽 계층. 안쪽으로는 프롬프트·컨텍스트·하네스·헤르메스를 '개선 대상(피개선물)'으로 삼아 감싼다. 횡단 계열인 평가(eval-eng)와 오케스트레이션(orchestration-eng)을 조직 차원으로 끌어올려 제도로 굳히는 자리다. 경계: 하위 네 겹이 '한 번 잘 만드는 것(구축)'이라면, 메타는 '계속 잘 유지·개선하는 것(운영·거버넌스)'이다. 평가가 '측정 도구'라면 메타는 그 측정치를 근거로 무엇을 바꿀지 결정하고 조직 규정으로 확정하는 '운항 규정'이다.
핵심 개념 (14)
코드를 고치기 전에 '무엇이 좋은 출력인가'를 데이터셋과 채점 기준으로 먼저 정의하고, 그 평가를 통과·향상하는 방향으로만 프롬프트·파이프라인을 바꾸는 개발 방식. 소프트웨어의 테스트주도개발(TDD)을 LLM 시스템에 적용한 것.
💡 '느낌으로 더 나아진 것 같다'를 '측정으로 더 나아졌다'로 바꿔 개선을 재현·누적 가능하게 만든다. 메타 계층의 나침반.
'이 입력에는 이런 출력이 옳다(또는 이런 성질을 만족해야 한다)'를 사람이 확정해 둔 대표 사례 모음. 회귀 테스트와 평가주도개발의 채점 기준지가 된다.
💡 평가의 기준점. 실무 실패사례·경계사례를 계속 추가해야 살아 있는 안전망이 된다.
프롬프트나 파이프라인을 바꿨을 때, 예전에 통과하던 대표 사례들이 여전히 통과하는지 자동으로 재검사하는 절차. 변경이 기존 품질을 몰래 깨뜨리는 것을 잡아낸다.
💡 LLM은 한 줄만 바꿔도 엉뚱한 곳이 깨진다. 회귀 테스트 없이는 개선이 곧 파괴가 될 수 있다.
모델·도구·요금·규정이 바뀔 때 '언제, 무엇을 기준으로, 어떤 절차로' 교체·갱신할지 정한 운영 규정. 새 모델을 기존 평가셋으로 먼저 검증한 뒤에만 전환한다.
💡 모델 교체는 조용한 품질 저하·비용 급변·안전 특성 변화를 부른다. 규정 없이는 '바꿨더니 나빠진 걸 몰랐다'가 된다.
더 큰 모델·더 긴 컨텍스트·더 많은 도구 호출은 품질을 올리지만 비용·지연을 높인다. 업무 위험도에 맞춰 이 셋의 균형점을 의식적으로 정하는 관리.
💡 무조건 최고 모델은 예산을 태우고, 무조건 싼 모델은 위험 업무를 그르친다. 위험 등급별로 다른 균형점이 필요하다.
AI 시스템의 입력·출력·비용·지연·실패율·사람개입률 등을 기록(로깅·트레이싱)하고 지표(KPI)로 집계해 볼 수 있게 만드는 것. '지금 잘 돌아가는가'를 눈으로 확인하는 계기판.
💡 측정하지 못하는 것은 개선할 수 없다. 관측성이 없으면 문제를 사후에, 그것도 민원으로만 알게 된다.
AI가 틀리거나 사고를 낸 사례를 비난 없이(blameless) 분석해 근본 원인을 찾고, 그 사례를 평가셋에 추가하며 재발방지책을 표준에 반영하는 순환.
💡 실패를 개인 탓으로 덮으면 같은 실패가 반복된다. 회고는 실패를 조직의 방어자산으로 전환한다.
개인정보 비식별, 외부 LLM 전송 방어, 저작권, 정치적 중립, 딥페이크 등 규정·윤리 준수 여부를 주기적으로 점검하고 증빙을 남기는 감사 활동.
💡 공공 영역에서 한 건의 위반이 신뢰 전체를 무너뜨린다. 감사는 안전을 일회 설계가 아닌 지속 점검으로 만든다.
프롬프트·컨텍스트·하네스·인터페이스의 모든 변경에 버전을 매기고, 무엇을 왜 바꿨는지 기록하며, 문제 시 이전 버전으로 즉시 되돌릴 수 있게 관리하는 것.
💡 AI 자산도 코드처럼 관리해야 한다. 롤백이 안 되면 나쁜 변경 하나가 서비스를 인질로 잡는다.
검증된 프롬프트·워크플로우·컨텍스트 묶음을 재사용 가능한 '레시피'로 자산화하고, 승인·버전·소유자·평가결과를 붙여 조직 대장에 등록·공유하는 것.
💡 개인기를 조직 역량으로 바꾸는 핵심 장치. 대장이 없으면 매번 바닥부터 다시 만들고 노하우는 퇴직과 함께 사라진다.
업무를 영향·되돌릴 수 없음 정도에 따라 등급(예: 저위험 자동, 중위험 사람검토, 고위험 반드시 결재)으로 나누고, 등급별로 필요한 사람 승인(사인오프) 절차를 규정하는 것.
💡 모든 것을 사람이 검토하면 자동화 이득이 없고, 아무것도 검토 안 하면 사고가 난다. 등급화가 그 사이의 위임전결선을 긋는다.
AI 산출물이 사람에게 실제 영향을 주기 전, 지정된 담당자가 검토·수정·승인하도록 강제하는 통제 지점. 메타 계층에서는 이 게이트의 배치·기준·기록을 제도로 관리한다.
💡 AI는 최종 판단자가 아니라 초안·보조여야 한다. 게이트가 그 원칙을 표어가 아닌 강제 절차로 만든다.
AI가 자기 출력을 평가·비평해 다음 출력을 개선하거나, 서브에이전트가 프롬프트·워크플로우를 자동 조정하는 루프를 사람이 경계·한도·기록과 함께 통제하는 것.
💡 자기개선은 강력하지만 통제 없이는 폭주·비용 급증·안전 이탈을 부른다. 메타는 자율에 반드시 울타리와 사인오프를 붙인다.
교육 콘텐츠·레시피·표준 문서를 만들 때 초안→법령/사실 검수→접근성 점검→승인→배포로 이어지는 품질보증 공정. '무증분 스키마'가 숨기는 저작·검수 비용을 정면으로 다룬다.
💡 콘텐츠·표준의 품질은 저절로 나오지 않는다. QA 공정이 없으면 틀린 매뉴얼이 조직 전체로 확산된다.
학습 목표
- 메타 엔지니어링이 '측정·개선·제도화'의 최외곽 계층임을 설명하고, 하위 네 겹과의 관계를 자기 말로 말할 수 있다
- '느낌으로 개선'과 '평가로 개선'의 차이를 예시로 구분한다
- 버전관리·변경로그·롤백이 왜 AI 자산에도 필요한지 행정 비유로 설명한다
- 리스크 등급화와 휴먼인더루프 게이트의 개념을 이해한다
- 대표 실패사례를 모아 골든 데이터셋(평가셋)을 만들고, 프롬프트 변경 전후로 회귀 테스트를 실행할 수 있다
- 비용·지연·품질 지표를 로깅해 간단한 대시보드/KPI로 집계한다
- 실패사례 회고를 blameless하게 진행하고 재발방지책을 평가셋·표준에 반영한다
- 검증된 워크플로우를 레시피로 자산화해 대장에 등록한다
- 모델 교체·최신성 거버넌스 규정(교체 기준·검증 절차·롤백 조건)을 설계·운영한다
- 업무 위험 등급별 사인오프 규정과 안전·규정 준수 감사 체계를 조직에 도입한다
- 자기개선 루프에 경계·한도·기록을 붙여 안전하게 운영한다
- 저작·검수 QA 파이프라인을 세워 조직 표준을 지속 재생산하고, 메타 계층 KPI를 리더십에 보고한다
세션 구성
| 회차 | 주제 | 시수 | 내용 | 산출물 |
|---|---|---|---|---|
| 1 | 왜 메타인가 — 낡는 시스템과 개선의 재현성 | 2h | AI 시스템이 낡는 4가지 경로(모델 교체·업무 변화·규정 개정·비용 변동)를 실제 시나리오로 체험. '느낌 개선 vs 평가 개선'의 차이를 before/after 시연으로 보이고, 메타 계층이 하위 네 겹을 '개선 대상 데이터'로 다룬다는 관점을 세운다. 행정 비유: 기획·감사 기능. | 우리 부서 AI 자산이 낡을 수 있는 지점 3개 진단 메모 |
| 2 | 평가주도개발과 골든 데이터셋 | 3h | '좋은 출력'을 채점 기준으로 정의하는 법. 실무 실패·경계 사례 10개로 소형 평가셋 만들기, 규칙기반 채점과 LLM-as-judge의 쓰임과 한계, 사람 채점과의 이원화. 평가를 먼저 짜고 프롬프트를 나중에 고치는 순서 훈련. | 우리 업무용 골든 데이터셋 v0(10사례) + 채점 기준표 |
| 3 | 회귀 테스트·버전관리·롤백 | 3h | 프롬프트/파이프라인 변경 전후 회귀 테스트 자동 실행. 모든 변경에 버전·변경로그를 붙이고 문제 시 즉시 롤백하는 규율. 변경 1건이 다른 사례를 깨는 상황을 직접 재현·발견. | 회귀 테스트 결과표 + 변경로그 템플릿 + 롤백 절차서 |
| 4 | 관측성·비용·품질 대시보드 | 3h | 입력·출력·비용·지연·실패율·사람개입률 로깅과 트레이싱. 위험 등급별 비용·성능·품질 트레이드오프 결정. 간단한 KPI 대시보드 구성과 이상징후 알림 기준 잡기. | 핵심 KPI 5종을 담은 대시보드 스케치 + 알림 임계값 표 |
| 5 | 최신성·모델교체 거버넌스 | 2h | 모델·도구·요금·규정 변화 감시. 새 모델을 기존 평가셋으로 먼저 검증한 뒤 카나리(부분)전환→전면전환→롤백조건으로 이어지는 교체 절차 설계. 도구 중립층/특화층 분리로 교체 비용 낮추기. | 모델교체 체크리스트 + 교체 결정 기록서식 |
| 6 | 리스크 등급화·사인오프·안전 감사 | 3h | 업무 영향·비가역성으로 위험 등급화, 등급별 휴먼인더루프 게이트와 위임전결식 사인오프 규정. 비식별·외부전송 방어·중립·저작권 준수 감사 항목과 증빙 남기기. 자기개선 루프에 울타리 붙이기. | 리스크 등급표 + 등급별 사인오프 규정 + 안전감사 체크리스트 |
| 7 | 실패 회고·재발방지·레시피 자산화·저작 QA | 3h | blameless 포스트모템 진행법, 실패를 평가셋으로 되먹이기. 검증된 워크플로우를 레시피로 자산화해 대장에 등록(소유자·버전·평가결과·승인). 저작→법령/사실 검수→접근성→승인→배포 QA 파이프라인 수립. 메타 KPI를 리더십에 보고하는 1장 서식. | 회고 보고서 1건 + 레시피 대장 등록 3건 + 저작 QA 파이프라인 도식 + 리더 보고 1장 |
실습 랩
랩 A — 골든 데이터셋으로 회귀 테스트 만들기
목표 · 프롬프트를 '느낌'이 아니라 '측정'으로 개선·검증하는 최소 루프를 손으로 돌려본다.
- 실무에서 자주 쓰는 프롬프트 1개(예: 민원 답변 초안 작성)를 고른다.
- 그 프롬프트에 넣을 대표 입력 10개를 모은다. 최소 3개는 '과거에 AI가 틀렸던' 실패·경계 사례로 채운다(합성/가짜 데이터 사용, 실제 개인정보 금지).
- 각 입력에 대해 '반드시 만족해야 할 성질'을 3~5개 채점 기준으로 적는다(예: 근거 출처 명시, 단정 대신 '초안임' 표기, 금칙 표현 없음, 존댓말 일관).
- 현재 프롬프트로 10개를 실행하고, 채점 기준별 통과/실패를 표에 기록한다(사람 채점). 이것이 기준선(baseline)이다.
- 프롬프트를 한 곳만 개선한다. 다시 10개를 실행해 같은 표로 채점한다.
- 두 표를 나란히 비교한다: 총점이 올랐는가? 이전에 통과하던 사례가 새로 깨지지(회귀) 않았는가?
- 회귀가 발견되면 그 사례를 '고정 회귀 세트'로 표시하고, 앞으로 모든 변경에서 반드시 재검사하기로 규칙을 정한다.
✅ 성공 기준 · 프롬프트 변경 전후를 같은 10사례·같은 채점 기준으로 비교한 표가 있고, '개선했으나 어딘가 깨진' 회귀를 최소 1건 실제로 발견·기록했다.
↗ 확장 · 규칙기반으로 자동 채점 가능한 기준(예: 금칙어 포함 여부)을 스크립트/수식으로 자동화하고, 나머지는 사람 채점으로 남겨 이원화한다. LLM-as-judge를 시험하되 사람 채점과 불일치하는 사례를 별도 기록한다.
랩 B — 모델교체 거버넌스 리허설
목표 · '새 모델로 바꿨더니 조용히 나빠진 걸 몰랐다'를 방지하는 교체 절차를 리허설한다.
- 랩 A의 골든 데이터셋을 그대로 재사용한다(이것이 교체 검증의 기준지가 된다).
- 현재 모델(A)로 10사례를 실행해 통과율·평균 비용·평균 지연을 기록한다.
- 교체 후보 모델(B)로 동일 10사례를 실행해 같은 3지표를 기록한다(모델이 하나뿐이면 온도·컨텍스트 길이 등 설정 변경을 '가상 교체'로 대신한다).
- 비교표를 만든다: 품질이 유지/향상되었는가, 비용·지연은 어떻게 변했는가, 특정 위험 사례에서만 나빠지지 않았는가.
- '교체 결정 기록서'를 채운다: 교체 사유, 검증 결과, 카나리(일부 업무만 먼저 전환) 범위, 롤백 조건(예: 고위험 사례 통과율이 X 미만이면 즉시 A로 복귀).
- 변경로그에 버전·날짜·담당자·평가결과 링크를 남긴다.
✅ 성공 기준 · 두 모델(또는 두 설정)을 동일 평가셋으로 비교한 표와, 롤백 조건이 명시된 교체 결정 기록서가 완성됐다.
↗ 확장 · '도구 중립층/특화층 분리' 관점에서, 모델 의존 부분을 한 곳으로 모아 다음 교체 비용을 낮추는 구조 개선 1가지를 제안한다.
랩 C — 실패 회고에서 재발방지·레시피 자산화까지
목표 · 한 건의 실패를 조직의 방어자산과 재사용 레시피로 전환하는 전체 순환을 체험한다.
- 최근(또는 가상의) AI 실패 사례 1건을 고른다. 예: AI가 폐지된 조항을 근거로 답변을 생성.
- blameless 포스트모템을 작성한다: 무슨 일이 있었나(사실) → 근본 원인(왜, 5 Whys) → 사람/절차/컨텍스트 중 어디의 결함인가 → 재발방지책.
- 그 실패 입력을 골든 데이터셋에 '고정 회귀 사례'로 추가한다. 앞으로 이 실패는 자동으로 감시된다.
- 재발방지책을 하위 계층에 반영한다: 컨텍스트에 '최신 법령만 인용' 규칙 추가, 하네스에 출처 검증 게이트 추가, 인터페이스에 '근거 조항 표기' 강제 등 중 해당하는 것.
- 이 개선된 워크플로우를 '레시피'로 정리한다: 이름·용도·입력·출력·주의사항·위험등급·소유자·버전·평가결과.
- 레시피 대장에 등록하고 사인오프(승인자)를 받는 서식을 채운다.
✅ 성공 기준 · blameless 회고서 1건, 평가셋에 추가된 회귀 사례 1건, 대장에 등록되고 승인란이 있는 레시피 1건이 모두 연결되어 존재한다.
↗ 확장 · 이 레시피에 리스크 등급을 매기고, 등급에 맞는 휴먼인더루프 게이트(누가·언제 검토·승인)를 규정에 명문화한다. 저작 QA 파이프라인(법령 검수·접근성 점검 단계 포함)에 이 레시피를 태워 본다.
사례 연구
상황 · 한 지자체가 복지 민원 답변 초안을 돕는 AI를 도입했다. 초기엔 잘 작동했으나, 몇 달 뒤 관련 지침이 개정되면서 AI가 '이미 폐지된 기준'을 근거로 답변 초안을 계속 만들어냈다. 담당자가 바쁠 때 그대로 나간 답변에서 민원인이 오안내를 받는 사고가 발생했다.
원인은 프롬프트나 모델이 아니라 '메타 계층의 부재'였다. (1) 개정된 지침이 컨텍스트(참고 자료철)에 반영되는 갱신 절차가 없었다(최신성 거버넌스 부재). (2) '폐지 조항 인용'을 잡아낼 회귀 테스트·평가셋이 없었다. (3) 고위험(민원인에게 직접 영향) 업무인데도 사람 사인오프 게이트가 형식적이었다. 개선은 이렇게 진행됐다: 개정 지침 반영을 정기 갱신 절차로 규정하고(freshness), 과거 실패 입력을 골든 데이터셋의 고정 회귀 사례로 추가했으며, '근거 조항의 유효성 표기'를 인터페이스에서 강제하고, 대외로 나가는 답변은 반드시 담당자 사인오프를 거치도록 리스크 등급별 게이트를 명문화했다. 반년 뒤 유사 사고는 회귀 테스트에서 사전 차단됐다.
교훈 · AI 사고는 대개 '한 번 잘 만들었으나 계속 관리하지 않아서' 난다. 최신성 갱신·회귀 테스트·위험등급별 사인오프라는 메타 3종 세트가 없으면, 좋은 시스템도 시간과 함께 조용히 위험해진다.
상황 · 한 팀이 문서 요약 파이프라인을 운영 중, 공급사가 새 모델 버전을 내놓자 '더 좋아졌겠지'라며 곧장 전면 교체했다. 며칠 뒤 특정 유형(표가 많은 문서) 요약에서 수치가 누락되는 문제가 사용자 항의로 드러났다.
새 모델은 평균 품질은 올랐지만 '표 포함 문서'라는 특정 하위 집합에서 회귀했다. 팀에 평가셋이 있었다면 교체 전에 잡았을 문제였다. 이후 팀은 절차를 바꿨다: 모든 모델 교체는 (1) 기존 골든 데이터셋으로 사전 검증하고, (2) 통과 시에도 곧장 전면 전환하지 않고 트래픽 일부만 새 모델로 보내는 카나리 전환으로 실사용 지표(품질·비용·지연)를 관측하며, (3) 고위험 하위 집합 통과율이 임계값 미만이면 자동 롤백하도록 규정했다. 또 모델 의존 코드를 한 어댑터 층으로 모아 다음 교체 비용을 낮췄다.
교훈 · '새 버전은 더 좋다'는 가정은 위험하다. 평가셋 사전검증 → 카나리 → 롤백 조건이라는 교체 거버넌스와 관측성이 없으면, 업그레이드가 곧 회귀가 된다. 평균 지표만 보지 말고 위험한 하위 집합을 반드시 따로 본다.
흔한 실패 · 안티패턴
- 느낌으로 개선하기: 평가셋 없이 프롬프트를 '더 나아 보인다'로 고쳐, 어제 되던 사례를 오늘 조용히 깨뜨린다.
- 평균 지표에 속기: 전체 통과율만 보고 특정 위험 하위 집합(고령자 민원·표 문서 등)의 회귀를 놓친다.
- 최신성 방치: 규정·모델·요금이 바뀌어도 컨텍스트와 절차를 갱신하지 않아, 시스템이 낡은 채로 굴러간다.
- 롤백 없는 변경: 변경로그·버전·되돌리기 경로가 없어, 나쁜 변경 하나가 서비스를 인질로 잡는다.
- 전부 사람검토 또는 전부 자동: 리스크 등급화 없이 극단으로 가 자동화 이득을 버리거나 사고를 방치한다.
- 비난하는 회고: 실패를 개인 탓으로 덮어 근본 원인을 못 찾고 같은 실패를 반복한다.
- 레시피 대장 부재: 검증된 노하우를 자산화하지 않아 매번 바닥부터 다시 만들고, 담당자 퇴직과 함께 역량이 증발한다.
- '무증분'이라는 착각: 저작·법령검수·접근성 QA 비용을 숨긴 채 콘텐츠·표준을 양산해 틀린 매뉴얼을 확산시킨다.
- 울타리 없는 자기개선: 서브에이전트·자기개선 루프를 경계·한도·기록 없이 풀어 비용 폭주·안전 이탈을 부른다.
- 형식적 사인오프: 게이트를 두었으나 실제로는 무비판 '확인' 도장이 되어 통제가 서류상으로만 존재한다.
평가
| 평가 기준 | 초급 | 능숙 | 전문 |
|---|---|---|---|
| 평가주도개발·회귀 테스트 | '평가로 개선한다'는 말의 의미는 알지만 스스로 평가셋을 만들지 못하고, 변경 전후를 감으로만 비교한다. | 실패·경계 사례로 골든 데이터셋을 만들고, 변경 전후를 같은 기준으로 회귀 테스트해 개선과 회귀를 구분한다. | 평가셋을 지속 관리(실패 되먹임)하고 채점을 규칙기반·사람·LLM-judge로 적절히 이원화하며, 조직의 평가 표준을 설계한다. |
| 최신성·모델교체 거버넌스 | 모델 교체가 위험할 수 있음을 인지하나 절차 없이 '새 버전이 낫겠지'로 전환한다. | 기존 평가셋으로 사전 검증하고, 교체 결정 기록·롤백 조건을 남긴다. | 카나리 전환·위험 하위집합 감시·자동 롤백을 규정으로 운영하고, 도구 중립/특화층 분리로 교체 비용을 낮춘다. |
| 리스크 등급화·사인오프·안전 감사 | 휴먼인더루프가 필요하다는 원칙은 알지만 모든 업무를 같게 다뤄 등급을 나누지 못한다. | 업무를 위험 등급으로 나누고 등급별 사인오프 게이트를 배치하며, 기본 안전 감사 항목을 점검한다. | 비가역성 기준의 위임전결식 게이트, 증빙 남기는 정기 감사, 자기개선 루프의 울타리까지 제도로 운영한다. |
| 제도화·자산화(레시피·QA·KPI) | 좋은 노하우를 개인 문서로만 갖고 있고 조직 공유·버전관리가 없다. | 검증된 워크플로우를 레시피로 자산화해 대장에 등록하고 변경로그·소유자를 관리한다. | 저작→검수→접근성→승인 QA 파이프라인과 메타 KPI 보고를 운영해 조직 표준을 지속 재생산한다. |
- 다음 중 '평가주도개발'에 가장 가까운 것은? (가) 프롬프트를 여러 번 바꿔 가장 마음에 드는 결과를 고른다 (나) 무엇이 좋은 출력인지 채점 기준·데이터셋을 먼저 정하고 그 점수를 올리는 방향으로만 고친다 (다) 최신 모델로 바꾸면 자동으로 좋아진다 (라) 사용자 항의가 오면 그때 고친다
- '회귀 테스트'가 LLM 시스템에서 필요한 이유를 한 문장으로 쓰시오.
- 모델을 새 버전으로 교체할 때 생길 수 있는 위험 2가지를 적으시오.
- 당신 부서의 반복 AI 업무 1개를 골라, 골든 데이터셋에 넣을 대표 입력 5개(그중 실패·경계 2개 이상)와 채점 기준 3개를 설계하시오.
- 업무 3개를 저·중·고위험으로 등급화하고, 각 등급에 어떤 휴먼인더루프 사인오프 게이트를 둘지 규정 형태로 쓰시오.
- 새 모델로의 교체를 승인하는 '교체 결정 기록서'에 반드시 들어가야 할 항목 5가지를 나열하고, 각각이 왜 필요한지 한 줄씩 설명하시오.
- 최근 AI 실패(또는 가상의 실패) 1건에 대해 blameless 회고를 작성하고, 그 실패를 (가) 평가셋 (나) 하위 계층 개선 (다) 재사용 레시피로 각각 어떻게 되먹일지 서술하시오.
읽을거리 · 도구
- 평가주도개발(eval-driven development) 관점의 실무 글 — '프롬프트를 느낌으로 고치지 말고 평가를 먼저 짜라'는 사고방식을 다룬 엔지니어링 블로그·가이드 (왜 읽나: 메타 계층의 나침반인 '측정 먼저' 습관을 몸에 익히기 위해. 특정 도구 튜토리얼보다 사고방식을 설명한 글을 골라라.)
- 소프트웨어 테스트주도개발(TDD)·회귀 테스트 기초 — TDD와 회귀 테스트의 원리를 설명한 표준 소프트웨어 공학 자료 (왜 읽나: LLM 평가·회귀 테스트는 이 고전 개념의 응용이다. 원형을 알면 AI판 회귀 테스트 설계가 쉬워진다.)
- 비난 없는 포스트모템(blameless postmortem) 방법론 — SRE/장애관리 커뮤니티의 blameless 회고 작성 가이드 (왜 읽나: 실패를 개인 탓이 아닌 시스템 결함으로 보고 재발방지로 전환하는 문화·양식을 배우기 위해. 행정 감사와 접목할 지점을 찾아라.)
- LLM 관측성·평가(observability & evaluation) 개념 정리 — LLM 애플리케이션의 로깅·트레이싱·평가 지표를 설명한 개념 문서 (왜 읽나: KPI 대시보드와 이상징후 알림을 무엇으로 구성할지 감을 잡기 위해. 특정 벤더 대시보드가 아니라 '무엇을 측정해야 하는가'에 집중해 읽어라.)
- AI 시스템의 모델 마이그레이션·버전 관리 실무 문서 — 모델 교체 시 사전검증·카나리·롤백 절차를 다룬 실무 가이드(공급사·오픈소스 문서 포함) (왜 읽나: 최신성 거버넌스의 구체적 절차를 남의 사례로 확인하기 위해. 수치·요금은 반드시 최신 공식 문서로 대조하라(이 커리큘럼은 특정 수치를 고정하지 않는다).)
- 공공부문 AI 도입·거버넌스·개인정보 지침류 — 정부·공공기관의 AI 활용 가이드라인, 개인정보 비식별·안전 관련 공식 지침 (왜 읽나: 안전·규정 준수 감사 항목을 조직의 실제 규정에 정렬하기 위해. 반드시 최신 개정본을 소관 기관 공식 출처에서 확인하라.)